
 還沒串接 Discord——串上讓片場參與記進 XP,每天還有 3 篇 DE/AI 精選
補充H - 對外服務:API 上雲與 Cloud Run
這是選讀的補充章,不在主線流程裡。前置:第 16 章做完(兩台 VM、Cloud SQL、Secret Manager 都在)。做完第 17 章之後再回來看也可以。
到第 16 章為止,系統只對「自己人」服務:發任務、看 Flower、查資料庫,全都要嘛 SSH 進機器、要嘛靠防火牆放行你一個人的 IP。本章把補充E 寫好的 FastAPI 部署上雲——給全世界一個固定的網址,並學會雲端時代的發佈流程:build → tag → push → deploy。部署的目的地不是 VM,而是 Cloud Run:把容器交給託管服務跑,這是資料工程師實務上把服務開出去的標準做法。
做完這一章你會
- 說得出對外服務要解的三個問題,以及託管服務怎麼一次回答
- 用 Artifact Registry 開一個私有 image 倉庫,走通 build → tag → push
- 一條指令把 API 容器部署上 Cloud Run,拿到固定的 HTTPS 網址,並用
--set-secrets讓密碼不出現在設定裡 - 用 ApacheBench 對正式網址壓測,讀懂 Requests per second 與 Failed requests
- 走一次 v1 → v2 的換版發佈與回滾,理解 revision 版本機制
- 說得出 Load Balancer 是什麼、為什麼你不用自己架一個
- 說得出部署後的 API 層為什麼是一個微服務,以及「一個元件微服務化」跟「系統微服務架構」的差別
先搞懂
對外服務要解的三個問題
第 14 章的「想一想」問過:VM 停機後外部 IP 會換,把網址發給別人用是什麼問題?現在正面回答。把服務開給外面的人用,馬上遇到三件事:
| 問題 | 具體長相 |
|---|---|
| IP 會換 | VM 每次重開外部 IP 就換,網址發出去隔天就失效 |
| 單台會掛 | 唯一一台 VM 重開機的那幾分鐘,服務就是斷的 |
| 一台扛不住 | 流量成長後單台 CPU 打滿 |
傳統解法是自己架 Load Balancer(負載平衡器):一個固定 IP 站在最前面,把請求分給後面一群機器,配上健康檢查自動繞開掛掉的。GCP 上把這套手動拼出來要七個零件——那是 infra/SRE 工程師的日常,不是資料工程師的。
資料工程師的答案是第 14 章學過的取捨:交給託管服務。本章用的 Cloud Run 是「容器的託管執行環境」(第 14 章對照表裡的「容器 Serverless」):你給它一顆 image,它還你一個固定的 HTTPS 網址——IP、備援、擴縮、憑證,全部它扛。三個問題一次消失。
Cloud Run:給它 image,拿回網址
| 你關心的事 | Cloud Run 的回答 |
|---|---|
| 網址 | 固定的 https://…run.app,部署當下就給你,永不換 |
| 機器 | 沒有機器——你看不到 VM,只管 image |
| 流量大 | 自動多開幾個容器分擔(水平擴充,第 7 章 --scale 的全自動版) |
| 沒流量 | 自動縮到 0 個容器,這段時間不計費——直接滿足本課程「下課要停機」的需求,而且不用自己動手 |
| 費用 | 按請求處理時間計費+每月免費額度(課程用量在免費額度內) |
它跟 GCE 是「託管 vs 自架」光譜的兩端:GCE 給你一台空機器什麼都自己來(IaaS);Cloud Run 只收 image 其他全包。第 16 章資料庫做過同一道選擇題(自架 MySQL vs Cloud SQL),這章輪到「跑服務的機器」。
什麼工作適合 Cloud Run,什麼不適合
課程裡只有 API 交給 Cloud Run,爬蟲 worker 和 Airflow 都還留在 VM 上。這不是因為做不到,而是工作的形狀不同:
| API(適合 Cloud Run) | Airflow scheduler(不適合) | |
|---|---|---|
| 什麼時候要做事 | 有人呼叫才做 | 一直醒著,每分鐘檢查有沒有到期的排程 |
| 沒事做的時候 | 縮到零,不計費 | 縮到零就不排程了 |
| 單次執行多久 | 幾百毫秒 | 一個 task 可能跑幾十分鐘 |
| 有沒有狀態 | 沒有,每個請求各自獨立 | 有,要持久化 logs 與執行紀錄 |
判斷的原則:「有人呼叫才做事、做完就結束、不用記住上次做了什麼」的工作適合 Cloud Run。API 完全符合,所以放上去很自然。
Airflow 的 scheduler 每一項都相反,它需要一直執行。Cloud Run 有 --min-instances=1 可以讓容器常駐,但那等於放棄了 Cloud Run 的所有優點(自動縮零、按量計費),成本還可能比一台 VM 高——這種時候就該用 VM 自架,或用專門的託管排程服務 Composer(第 17 章會比較)。
爬蟲 worker 的情況類似:它要一直連著 RabbitMQ 等任務進來,屬於常駐型,所以留在 VM2 上。
這章做完,API 層就是一個微服務
部署上 Cloud Run 之後,stock-api 具備微服務的全部特徵:
| 微服務的特徵 | stock-api 在本章的對應 |
|---|---|
| 獨立容器、獨立部署 | 自己的 image、自己的 deploy 指令,改版不動系統其他部分 |
| 無狀態 | 每個請求各自獨立,狀態全部在資料庫裡 |
| 自動擴縮 | 流量大自動多開容器、沒流量縮到零 |
| 版本化交付 | image v1/v2+revision,換版零停機、回滾一條指令 |
| 透過網路介面對外 | 固定 HTTPS 網址,呼叫方只認網址不認機器 |
範圍要說清楚:微服務化的是 API 這一層,也只有這一層——它是課程系統裡第一個、也是唯一一個微服務化的零件。worker、Airflow、RabbitMQ 都留在 VM 上,資料庫是全系統共用的一顆。整個系統的準確定位是「分散式任務處理系統+一個微服務化的 API 元件」,不是微服務架構。服務邊界怎麼拆、拆完資料怎麼分,屬於微服務架構設計的範疇,本課程不涵蓋。
Image 倉庫:build 一次,到處跑
第 16 章開 VM2 的時候,worker image 是在 VM2 上重新 build 出來的——clone repo、build、等它跑完。這條路走不遠:每台各 build 一次既慢,又不能保證 build 出來完全一樣;而且 Cloud Run 根本沒有讓你 build 的機器——它只收「放在倉庫裡的 image」。
解法是 image 倉庫(registry):build 一次 → push 上去 → 誰要跑誰去 pull。你其實早就用過它——第 3 章 docker pull rabbitmq 拉的就是公共倉庫 Docker Hub。本章用的 Artifact Registry 是 GCP 的私有倉庫:課程的 API image 沒有理由公開,放自己專案裡,用 GCP 的身分機制控管誰能推、誰能拉。
私有倉庫的 image 名字比 rabbitmq 長很多,拆開看就懂:
asia-east1-docker.pkg.dev / stock-crawler-course / stock-repo / stock-api : v1
└──── 倉庫伺服器(區域)────┘ └───── 專案 ID ─────┘ └─ 倉庫名 ─┘ └─ image ─┘ └tag┘
:v1 這段叫 tag——同一個 image 的版本標籤(第 10 章 build -t 的 -t 就是它,只是當時沒管版本)。發佈新版本不是覆蓋舊的,而是推一個新 tag(v2)上去;舊版還在倉庫裡,出問題時可以退回去。本章結尾的「換版」就是用這個機制。
發佈流程:雲端時代的「上版本」
把這一章的動作串起來,就是業界每天在跑的發佈流程:
改程式 → docker build → docker tag(標版本)→ docker push(上倉庫)
                                                      │
                              gcloud run deploy ◀─────┘(Cloud Run 去倉庫拉新版、無縫切換)
換版的瞬間服務不中斷——Cloud Run 會先把新版本容器起好、確認能服務了,才把流量切過去。這叫零停機部署;自己架 LB 的世界裡要靠「多台+健康檢查+輪流換」手動達成,託管世界裡它是內建的。
一步一步
開工前抄好三個值(Cloud Run 網址做到 Part D 才會有):
值 查法 你的值 VM1 外部 IP gcloud compute instances list______ Cloud SQL IP gcloud sql instances list______ Cloud SQL 連線名稱 gcloud sql instances describe stock-mysql --format="value(connectionName)"______
Step 0:喚醒系統(含一件新的事)
本章只需要 VM1(拿它當 build 機)和 Cloud SQL——VM2 讓它繼續睡。復原流程照第 16 章,但這次趁 VM 還停著多做一件事:
# 1. Cloud SQL 喚醒
gcloud sql instances patch stock-mysql --activation-policy=ALWAYS

# 2. 趁停機改 VM 的存取範圍(本章要從 VM 推 image 上倉庫,預設範圍是唯讀)
gcloud compute instances set-service-account stock-crawler-vm \
  --zone=asia-east1-b --scopes=cloud-platform

# 3. 開機
gcloud compute instances start stock-crawler-vm --zone=asia-east1-b

# 4. 查新的外部 IP(換了!抄進上面的表)
gcloud compute instances list

# 5. 用新 IP 重授權 Cloud SQL(VM1 待會要本機測 API 連線用)
gcloud sql instances patch stock-mysql --authorized-networks={VM1外部IP}/32
第 2 步解釋一下。VM 的「身分」是它的服務帳戶(Compute Engine 預設服務帳戶,掛的是 Editor 這個涵蓋很廣的角色),但 VM 上還有一道舊式的限制叫存取範圍(scopes):就算身分有權限,scopes 沒開放的操作一樣做不了。預設的 scopes 對 Storage 只有唯讀權限,而推 image 屬於寫入,會被擋下來並回報 401 錯誤。--scopes=cloud-platform 的意思是「scopes 不設限,權限完全由 IAM 角色決定」。這個設定只能在停機狀態下修改,所以放在 Step 0 跟開機一起做;開機後才想到的話,就得再停一次機(IP 會再換一次,授權網路也要重設)。
另外確認一件事:Cloud Run 執行容器時,預設也是用 Compute Engine 預設服務帳戶的身分。第 16 章 Part B-2 授權過這個帳戶讀取 mysql-password,所以本章的 Cloud Run 直接就有權限。如果你當時授權給的是別的服務帳戶,這裡要補一次授權,指令跟第 16 章相同。
Part A:開一個 image 倉庫
gcloud services enable artifactregistry.googleapis.com

gcloud artifacts repositories create stock-repo \
  --repository-format=docker \
  --location=asia-east1
stock-repo 是倉庫名(自取);--repository-format=docker 指定放 Docker image(Artifact Registry 也能放 Python 套件等其他格式);--location 跟其他資源同區。建好後,倉庫的網址就是「先搞懂」拆過的那段:asia-east1-docker.pkg.dev/{你的專案ID}/stock-repo。
Part B:在 VM1 上 build 與 push
repo 裡已經有一份 api/Dockerfile——跟 worker 的 Dockerfile 同一套 uv 基底,差別只在最後一行 CMD:worker 那顆跑 celery,這顆跑 uvicorn api.main:app --host 0.0.0.0 --port 8000(--host 0.0.0.0 才收得到容器外的請求;不開 --reload,這是上線模式)。
SSH 進 VM1 操作。本章的 docker 指令都不加 sudo——原因等一下講:
gcloud compute ssh stock-crawler-vm --zone=asia-east1-b

# 在 VM1 上:拉最新程式
cd stock-crawler && git pull

# 讓 docker 認得 GCP 倉庫的登入方式(VM 自帶 gcloud,用 VM 的服務帳戶身分,免金鑰)
gcloud auth configure-docker asia-east1-docker.pkg.dev --quiet

# build → tag → push(REG 換成你的專案 ID)
REG=asia-east1-docker.pkg.dev/{你的專案ID}/stock-repo
docker build -f api/Dockerfile -t stock-api:v1 .
docker tag stock-api:v1 $REG/stock-api:v1
docker push $REG/stock-api:v1三條指令各做一件事:build 在本機做出 image(名字暫時叫 stock-api:v1);tag 幫同一顆 image 多掛一個「倉庫格式」的名字——push 是看名字決定推去哪的,名字不帶倉庫網址就推不上去;push 逐層上傳。成功的最後一行長這樣:
v1: digest: sha256:5865cd7d... size: 856為什麼不加 sudo?configure-docker 把「怎麼登入 GCP 倉庫」寫進你這個使用者的 ~/.docker/config.json;sudo docker 是用 root 身分跑的,讀的是 root 的設定檔——裡面沒有這段,push 就會 401。第 14 章做過 usermod -aG docker $USER,重新 SSH 登入後 docker 不用 sudo 就能跑,兩邊身分一致,這個坑就不存在。
Part C:先在 VM1 上跑起來看看
部署上雲之前,先在 VM1 本機驗證這顆 image 是好的:
# 在 VM1 上
docker run -d --name stock-api -p 8000:8000 \
  -e MYSQL_HOST={CloudSQL IP} \
  -e MYSQL_PORT=3306 \
  -e MYSQL_ACCOUNT=root \
  -e GCP_PROJECT_ID={你的專案ID} \
  $REG/stock-api:v1
這些 -e 蓋掉 crawler/config.py 的預設值,讓 API 連向 Cloud SQL——跟第 16 章 override 檔同一個做法,只是這次用 docker run -e 傳。
注意這裡沒有傳密碼,只傳了 GCP_PROJECT_ID。密碼由第 16 章建立的 Secret Manager 提供:容器裡的 config.py 會拿這個專案 ID 去讀 secret,用的是 VM 的服務帳戶身分。資料庫名也不用傳,api/main.py 裡固定連 mydb,正是第 16 章 worker 寫入的那個資料庫。
容器起來後要等約 30 秒(uv 在容器裡準備環境),再驗證:
# 在 VM1 上
curl http://localhost:8000/
# {"status":"ok","database":"connected"}

curl http://localhost:8000/stocks
# [{"stock_id":"00679B","records":...,...},{"stock_id":"2330",...}]
/ 是健康檢查端點(補充E 寫的):連資料庫丟一句 SELECT 1,通了回 ok。回 degraded 的話是資料庫連不上——十之八九是 Step 0 第 5 步的授權網路沒做。
確認 image 是好的之後,把測試容器收掉:
docker rm -f stock-api注意此刻它只活在 VM1 的 8000——外面的人連不進來(防火牆沒開 8000),而且就算開了,IP 會換、單台會掛、一台扛不住三個問題一個都沒解。該上 Cloud Run 了。
Part D:部署上 Cloud Run
回你自己的電腦(或留在 VM1 都行,gcloud 指令兩邊等價)。先啟用 API,然後一條 deploy:
gcloud services enable run.googleapis.com

gcloud run deploy stock-api \
  --image=asia-east1-docker.pkg.dev/{你的專案ID}/stock-repo/stock-api:v1 \
  --region=asia-east1 \
  --port=8000 \
  --add-cloudsql-instances={Cloud SQL連線名稱} \
  --set-env-vars="MYSQL_UNIX_SOCKET=/cloudsql/{Cloud SQL連線名稱},MYSQL_ACCOUNT=root" \
  --set-secrets="MYSQL_PASSWORD=mysql-password:latest" \
  --allow-unauthenticated \
  --memory=1Gi
參數逐一看:
--image:要執行倉庫裡的哪顆 image。Cloud Run 自己去 pull,這就是 Part B 把 image push 上去的意義--port=8000:容器裡 uvicorn 監聽的 port,Cloud Run 把對外流量轉進來--add-cloudsql-instances搭配MYSQL_UNIX_SOCKET:這兩個是一組的。前者會在容器裡接好一條通往 Cloud SQL 的專線,後者告訴程式改走這條專線。好處是授權網路完全不用設定——Cloud Run 的容器沒有固定 IP 可以填進授權清單,Google 直接從內部把線接好。api/main.py裡有一段切換邏輯:有設MYSQL_UNIX_SOCKET就走專線、沒設就走MYSQL_HOST,所以本機和 VM 的用法不受影響--set-secrets:密碼不寫在指令裡,寫的是「去 Secret Manager 拿mysql-password這顆的最新版」。這是第 16 章建立的那顆 secret--allow-unauthenticated:允許匿名存取,也就是誰都能呼叫這個 API。不加的話,呼叫方要帶 Google 身分憑證--memory=1Gi:容器記憶體上限(預設的 512Mi 對 pandas 來說偏緊)
--set-env-vars 和 --set-secrets 的差別要分清楚,這是本章的安全重點:
--set-env-vars |
--set-secrets |
|
|---|---|---|
| 你寫進指令的 | 值本身(例如 MYSQL_PASSWORD=1234) |
一個參照(secret 名稱+版本) |
| 部署後存在哪 | 值存在 Cloud Run 的設定裡 | 設定裡只有參照,值留在 Secret Manager |
| Console 上看得到什麼 | 看得到 1234 |
看得到「密鑰:mysql-password:latest」 |
| 換密碼要做什麼 | 重新部署一次 | Secret Manager 加新版本,容器重啟就拿到 |
用途也很明確:不敏感的設定用 --set-env-vars,密碼、金鑰這類機密用 --set-secrets。
跑完的最後兩行是這一章的重點輸出:
Service [stock-api] revision [stock-api-00001-kfp] has been deployed and is serving 100 percent of traffic.
Service URL: https://stock-api-{一串數字}.asia-east1.run.app
Service URL 就是這個服務對外的網址:固定、HTTPS、全球可連。從你自己的電腦(或手機)驗證:
curl https://stock-api-{一串數字}.asia-east1.run.app/
# {"status":"ok","database":"connected"}

curl https://stock-api-{一串數字}.asia-east1.run.app/stocks/2330/latest
# {"date":"...","stock_id":"2330","close":...,...}
這個網址可以給任何人使用:不需要 SSH、不需要防火牆授權,VM 關機也不影響(它執行的是倉庫裡的 image,跟 VM 已經無關)。系統第一次有了對外可用的網址,而過程中你沒有管理任何一台機器。
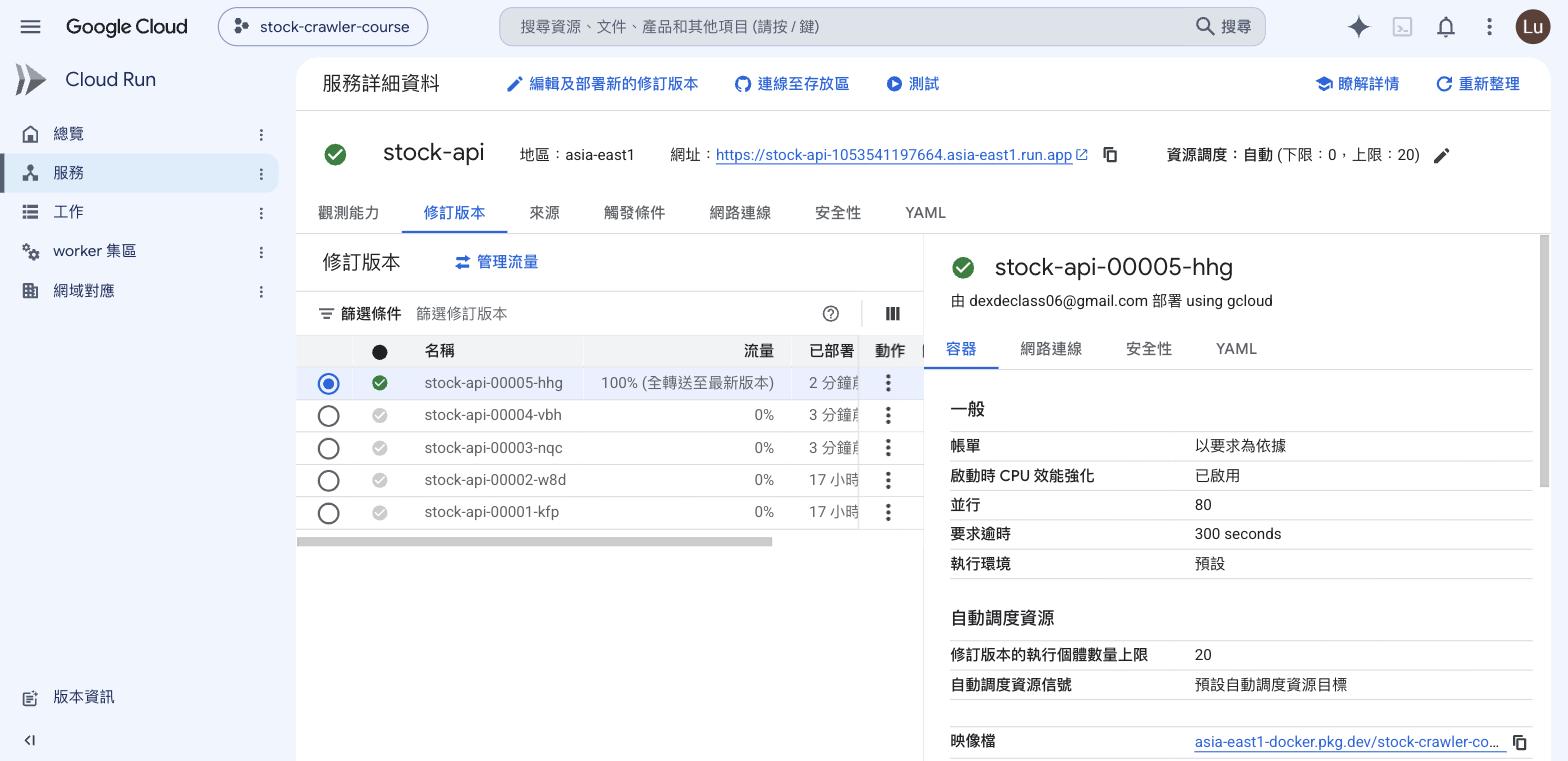
另外留意輸出裡的 revision [stock-api-00001-kfp]。revision 是這次部署的版本快照,內容包含 image、環境變數與各項設定。每部署一次就多一個 revision,舊的會保留下來,Part F 的換版與回滾用的就是它。
Console 上看得到這些 revision(≡ → Cloud Run → 點 stock-api → 修訂版本分頁)。流量欄位顯示目前是哪一版在服務:
驗證密碼真的沒有明碼存在設定裡:在同一頁往下捲,找到「環境變數」區塊。你會看到 MYSQL_UNIX_SOCKET 和 MYSQL_ACCOUNT 顯示的是實際的值,但 MYSQL_PASSWORD 顯示的是「密鑰:mysql-password:latest」——也就是一個參照,看不到 1234:
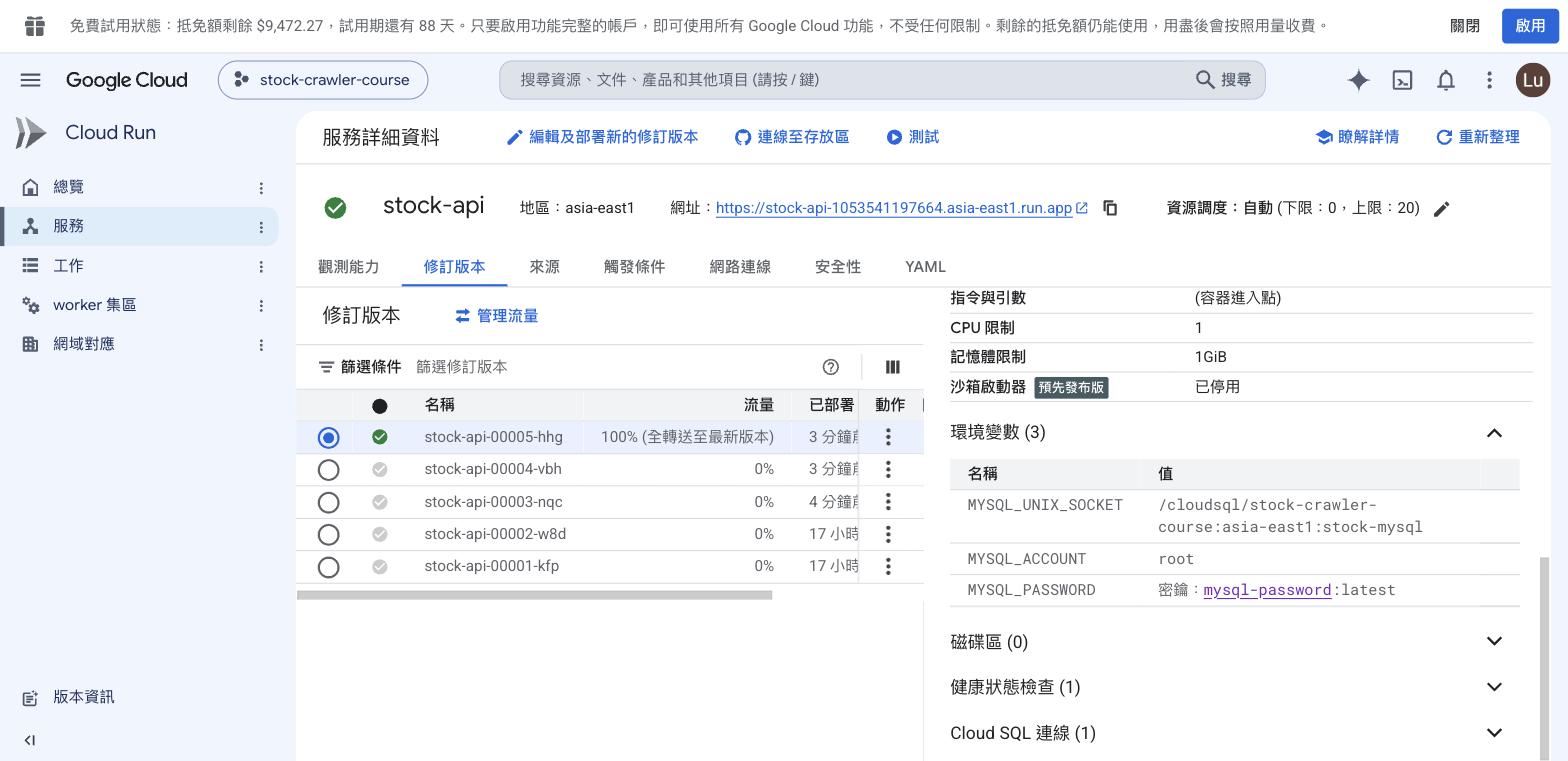
如果剛才用的是 --set-env-vars="MYSQL_PASSWORD=1234",這裡就會直接顯示 1234,任何有這個專案讀取權限的人都看得到。
Part E:壓力測試
服務開出去了,接下來測它能承受多少流量。用 ApacheBench 壓測(macOS 內建,路徑 /usr/sbin/ab;Windows 可用 WSL 安裝 apache2-utils):
ab -n 200 -c 10 https://stock-api-{一串數字}.asia-east1.run.app/stocks-n 200 共發 200 個請求、-c 10 同時 10 個併發——模擬 10 個人同時狂打。輸出重點三行:
Requests per second:    88.86 [#/sec] (mean)
Time per request:       112.536 [ms] (mean)
Failed requests: 0- Failed requests 必須是 0——服務在併發下穩定的證據
- Requests per second 是吞吐量:每秒能服務幾個請求。數字本身跟網路與當下狀態有關,重要的是它給了你一條基準線——之後任何改動都能量出變快還是變慢
- Time per request 是使用者體感的延遲(HTTPS+跨網路,比第 16 章內網數字大是正常的)
如果壓測規模再大十倍,Cloud Run 會自動多開容器分擔——你什麼都不用做。這就是「一台扛不住」問題的託管式答案。
Part F:發佈 v2——換版與回滾
模擬一次真實的發佈:程式改好了(這裡不真的改程式,直接把 v1 重新標成 v2——流程一模一樣),推新版、切換:
# 在 VM1 上:標 v2、push
docker tag stock-api:v1 $REG/stock-api:v2
docker push $REG/stock-api:v2

# 部署 v2(其他設定沿用上次的,只要給新 image)
gcloud run deploy stock-api \
  --image=asia-east1-docker.pkg.dev/{你的專案ID}/stock-repo/stock-api:v2 \
  --region=asia-east1
deploy 進行的期間,從另一個終端機每兩秒 curl 一次網址——全程 200,沒有任何一次失敗。Cloud Run 先把 v2 的容器起好、確認健康,才把流量從 v1 切過去:零停機換版,內建。
換完看版本清單:
gcloud run revisions list --service=stock-api --region=asia-east1
# REVISION             ACTIVE
# stock-api-00002-w8d  yes      ← v2,正在服務
# stock-api-00001-kfp           ← v1,留著
v2 上線後發現有 bug?一條指令退回 v1,不用重新 build、不用重新 push:
gcloud run services update-traffic stock-api --region=asia-east1 \
  --to-revisions=stock-api-00001-kfp=100

# 確認退回去了、服務照常
curl -s -o /dev/null -w "%{http_code}\n" https://stock-api-{一串數字}.asia-east1.run.app/stocks
# 200

# 玩完切回最新版
gcloud run services update-traffic stock-api --region=asia-east1 --to-latest
倉庫裡的 image 有版本(v1/v2),Cloud Run 的部署也有版本(revision),兩層都能退回。--to-revisions 也可以寫 00001=50,00002=50 讓兩個版本各分一半流量,這種做法叫金絲雀發佈:先讓新版承接一小部分流量,確認沒問題再全部切換。
那 Load Balancer 呢?
一頁把它講完。傳統上「固定入口+分流+健康檢查」要自己拼一台 Load Balancer:GCP 上是 instance group(機器名冊)、health check(巡邏)、backend service(調度)、url map(路由)、proxy+forwarding rule(入口)等七個零件接成的管線——這是 infra/SRE 工程師的日常工具。
你不用自己拼的原因很直接:Cloud Run 的網址背後,Google 已經幫你放了一台——每個請求先落在 Google 的邊緣節點,再被分給你的容器(可能不只一個),健康檢查與擴縮全自動。這正是第 14 章那句「越往託管走、要管的越少」的具體長相。什麼時候才需要自己架?服務跑在自管的 VM/K8s 上、要做複雜的路由規則(不同路徑導不同後端)、或要掛自己的網域與憑證策略時——那已經是另一個職位的工作範圍,你知道找誰、講得出需求,就夠了。
收工:只停要錢的
gcloud sql instances patch stock-mysql --activation-policy=NEVER
gcloud compute instances stop stock-crawler-vm --zone=asia-east1-b
Cloud Run 不用停——沒有流量它自動縮到 0 個容器,不產生任何費用;服務與網址保留,下次有請求進來它再醒過來(第一個請求會慢幾秒,這叫冷啟動,是縮到零的代價)。Artifact Registry 的 image 留著(儲存費極低)。
檢查:這一章做完的狀態
-
gcloud artifacts repositories list看得到 stock-repo;倉庫裡有 stock-api 的 v1 與 v2 - VM1 能用倉庫路徑跑起容器,
curl localhost:8000/回"status":"ok" -
gcloud run services list看得到 stock-api;從自己電腦 curl Service URL 通 -
ab壓測 Failed requests = 0 - 完成 v1 → v2 的換版與回滾,
revisions list看得到兩個版本 - 收工:VM 與 Cloud SQL 已停(Cloud Run 留著,縮零不計費)
想一想
--add-cloudsql-instances接的「專線」技術名稱叫 unix socket:程式連的不是IP:port而是容器裡的一個檔案路徑,Google 把這個路徑接到你的資料庫。為什麼 Cloud Run 不能像第 16 章那樣用「授權網路」連 Cloud SQL?(提示:授權網路要填來源 IP,Cloud Run 的容器有固定 IP 嗎?)- 縮到零的代價是冷啟動——第一個請求要等容器醒來。什麼樣的服務不能接受冷啟動?Cloud Run 的解法是
--min-instances=1(至少留一個容器醒著),代價是什麼? - 健康檢查端點
/在資料庫掛掉時回degraded但 HTTP 狀態碼還是 200——對「自動判斷服務好壞」的系統來說,這是好設計嗎?該怎麼改?(提示:讓檢查失敗的方式是回 5xx)
練習
- 實際改一次程式:在
api/main.py的/回應裡加一個"version": "v3"欄位,完整執行 build → tag v3 → push → deploy,用 curl 驗證新欄位上線且過程中服務不中斷 - 用
--to-revisions={v3的revision}=50,{v2的revision}=50做一次金絲雀發佈,連續 curl/十次,觀察 version 欄位兩種值交替出現 - 把
ab的-c從 10 拉到 50,比較 Requests per second 與 Time per request 的變化——吞吐量和延遲的取捨
排錯
| 症狀 | 原因 | 處理 |
|---|---|---|
docker push 回 401 unauthenticated |
①VM 的 scopes 還是預設唯讀 ②用了 sudo docker(讀不到你的登入設定) |
①停機 → set-service-account --scopes=cloud-platform → 開機(IP 換了記得重授權)②不加 sudo 重跑;groups 確認在 docker 群組裡 |
docker build 報 no space left on device |
20GB 磁碟被舊 image/build cache 塞滿 | docker system prune -af 清掉沒在用的(注意:它會把沒在跑的 image 全清掉,第 17 章要用的 stock-airflow 得重 build) |
| VM1 測試容器 curl 回 000 | uv 還在容器裡準備環境 | 等 30 秒;docker logs stock-api 看到 Application startup complete 就緒 |
VM1 測試 / 回 degraded |
授權網路是舊 IP,或 Cloud SQL 沒醒 | 重跑 Step 0 的第 4、5 步 |
run deploy 說 image 拉不到 |
image 路徑打錯,或 push 根本沒成功 | gcloud artifacts docker images list $REG 確認倉庫裡有它 |
Cloud Run 網址回 degraded |
--add-cloudsql-instances 或 MYSQL_UNIX_SOCKET 其中一個沒給/打錯(兩個是一組的) |
兩個參數裡的連線名稱要一模一樣;改完重新 deploy |
| Cloud Run 網址回 403 | 沒給 --allow-unauthenticated |
重新 deploy 加上它 |
| 網址通但第一次特別慢 | 冷啟動——容器從 0 醒來 | 正常現象;在意的話 --min-instances=1(會開始計費) |
本章總結
- 對外服務的三個問題——IP 會換、單台會掛、一台扛不住——資料工程師的答案是交給託管服務,不是自己架 LB
- Image 倉庫讓「build 一次、到處跑」成立;私有倉庫的名字=伺服器/專案/倉庫/image/tag 五段
- Cloud Run:給它 image、拿回固定 HTTPS 網址;自動擴縮、閒置縮零不計費、冷啟動是縮零的代價
- 連 Cloud SQL 走
--add-cloudsql-instances的專線,授權網路不用碰——託管環境連託管資料庫的標準姿勢 - 發佈流程 build → tag → push → deploy;revision 讓換版零停機、回滾一條指令
- LB 沒有消失,只是 Google 幫你管了——需要自己拼七件套的場景屬於 infra/SRE,你知道找誰就夠
- 部署完成後,API 層是課程系統裡第一個、也是唯一一個微服務化的零件——獨立部署、無狀態、自動擴縮、版本化回滾;系統整體仍不是微服務架構
回到主線:第 17 章把爬蟲到 BigQuery 的每日管線用 Airflow 排程串起來。本章手動做的 build → push → deploy 三步,補充I 會接進 GitHub Actions 的 workflow——測試通過自動部署,CI/CD 就完整了。
 送件鴿